OpenAI 训练并部署激活分类器作为前沿模型安全监控层
Training activation classifiers for safety and alignment
OpenAI 自 GPT-5.6 起在其最强模型的内部和外部流量上部署激活分类器(probes),利用模型内部激活逐 token 实时评分,可在生成中途阻断违规回复和工具调用并交由推理模型复审。实验显示 probes 比更大的文本分类器对测试的越狱攻击更鲁棒,准确率随模型能力提升,且在后训练各检查点间迁移良好,但需为新基础模型重新训练,且只能检测可显式训练的已知违规类型。
OpenAI 官方披露激活分类器的架构、训练与部署细节,并给出其相对文本分类器在越狱鲁棒性上的实验对比。
2026年11月2日 · Alex Makelov, Xiaojun Xu, Sundaram Ananthanarayanan, Ethan Mcdonald, Tom Dupre la Tour
TL;DR我们将激活分类器(又称探针)训练并部署为额外的一层安全防护,用于我们能力最强的模型。探针是高效的实时监控器,利用模型内部的激活值来检测可能违反策略的行为。
- 在生成过程中同步监控。探针会逐个 token 对助手的回复打分,因此可以在回复生成过程中即时中断响应、拦截工具调用,并在推理模型进行全面审查时暂停该回复的生成
- 实证表现令人期待。在我们的实验中,面对测试过的越狱攻击,探针比基于文本的分类器更稳健;其表现通常随被监控模型能力的提升而提升,并且能在多个后训练检查点之间良好迁移。
探针是对其他安全措施的补充,而非替代。探针通过监督方式训练,因此只能检测我们能够明确训练它去检测的内容。由于探针依赖被监控模型的激活值,新的基础模型需要重新训练探针,而且随着模型权重变化,可能也需要重新训练。
引言
在 OpenAI,我们训练模型以安全、对齐的方式行事。尽管这一方向近来取得了进展[OpenAI, 2026b],但仍存在一些情况:对抗性压力、罕见情形或训练失败可能削弱安全性与对齐。为此,我们采用“纵深防御”策略:在部署模型时附加监控器,用于检测这类情况并阻止模型进一步行动。具体来说,我们使用运行在用户提示词和助手回复上的文本分类器来实现这一目的。从 GPT-5.6 起[OpenAI, 2026a],我们在这套防护体系中又增加了一层:运行在所有助手回复上的激活分类器。
激活分类器,简称探针,是轻量级机器学习模型,利用 LLM 自身的内部激活值——即它的“神经模式”——来判断模型活动是否偏离对齐或存在其他不良情况(例如用户活动带有有害意图)。与外部基于文本的分类器相比,探针有多项优势:它们支持流式决策,可以在模型某一轮对话进行到一半时拦截违反策略的内容;面对越狱攻击,比规模大得多的文本分类器更稳健;运行效率也显著更高。此外,探针的准确率通常随模型能力同步提升:在能力更强的模型激活值上训练的探针,本身就是更强的分类器。
探针的一个根本局限在于依赖有标注的训练数据;我们只能用它检测已知且可测量的不良活动类型。探针还有一些运行层面的限制,源于它与被监控模型前向传播的紧密耦合。在一个模型激活值上训练的探针,与权重初始化不同的另一个模型的激活值不兼容。尤其是,每出现一个新的预训练基础模型,探针都需要重新训练。即便在同一基础模型系列内,随着模型权重偏离训练探针时所用的检查点,探针性能也可能下降,因此需要定期重新训练[见迁移部分]。
我们已在能力最强的模型的内部和外部流量上部署了探针。它是我们内部失准监控系统的一个组成部分,与基于模型的审查、自动化调查和人工响应并列。这篇博文介绍我们的方法以及一些重要发现。下图数据来自各项内部实验,未必能代表实际部署的分类器。
方法
架构
探针以残差流激活向量为输入(通常取自模型中间某一层),输出对应二分类任务的 logits(例如预测某段补全是否违反给定策略)。
我们的架构基于 Attention probes [Kantamneni et al. (2025)],采用 MLP + QV-attention 结构,并加入指数移动平均。1 与滚动均值([McKenzie et al. (2026)]、[Kramar et al., 2026])相比,指数移动平均把探针的流式状态内存从 O(window_size * num_heads) 降到 O(num_heads)。实践中我们发现,两种方法的预测能力基本没有差别。我们还额外加入了一个可学习的 pre-MLP 偏置,其初始值取自训练激活均值(负值)的估计;我们发现这能让训练中的优化更稳定。在许多领域,我们训练多输出探针,在共享探针大部分权重的同时提高分类的粒度。这有助于某些训练数据有限的输出类别更好地泛化。
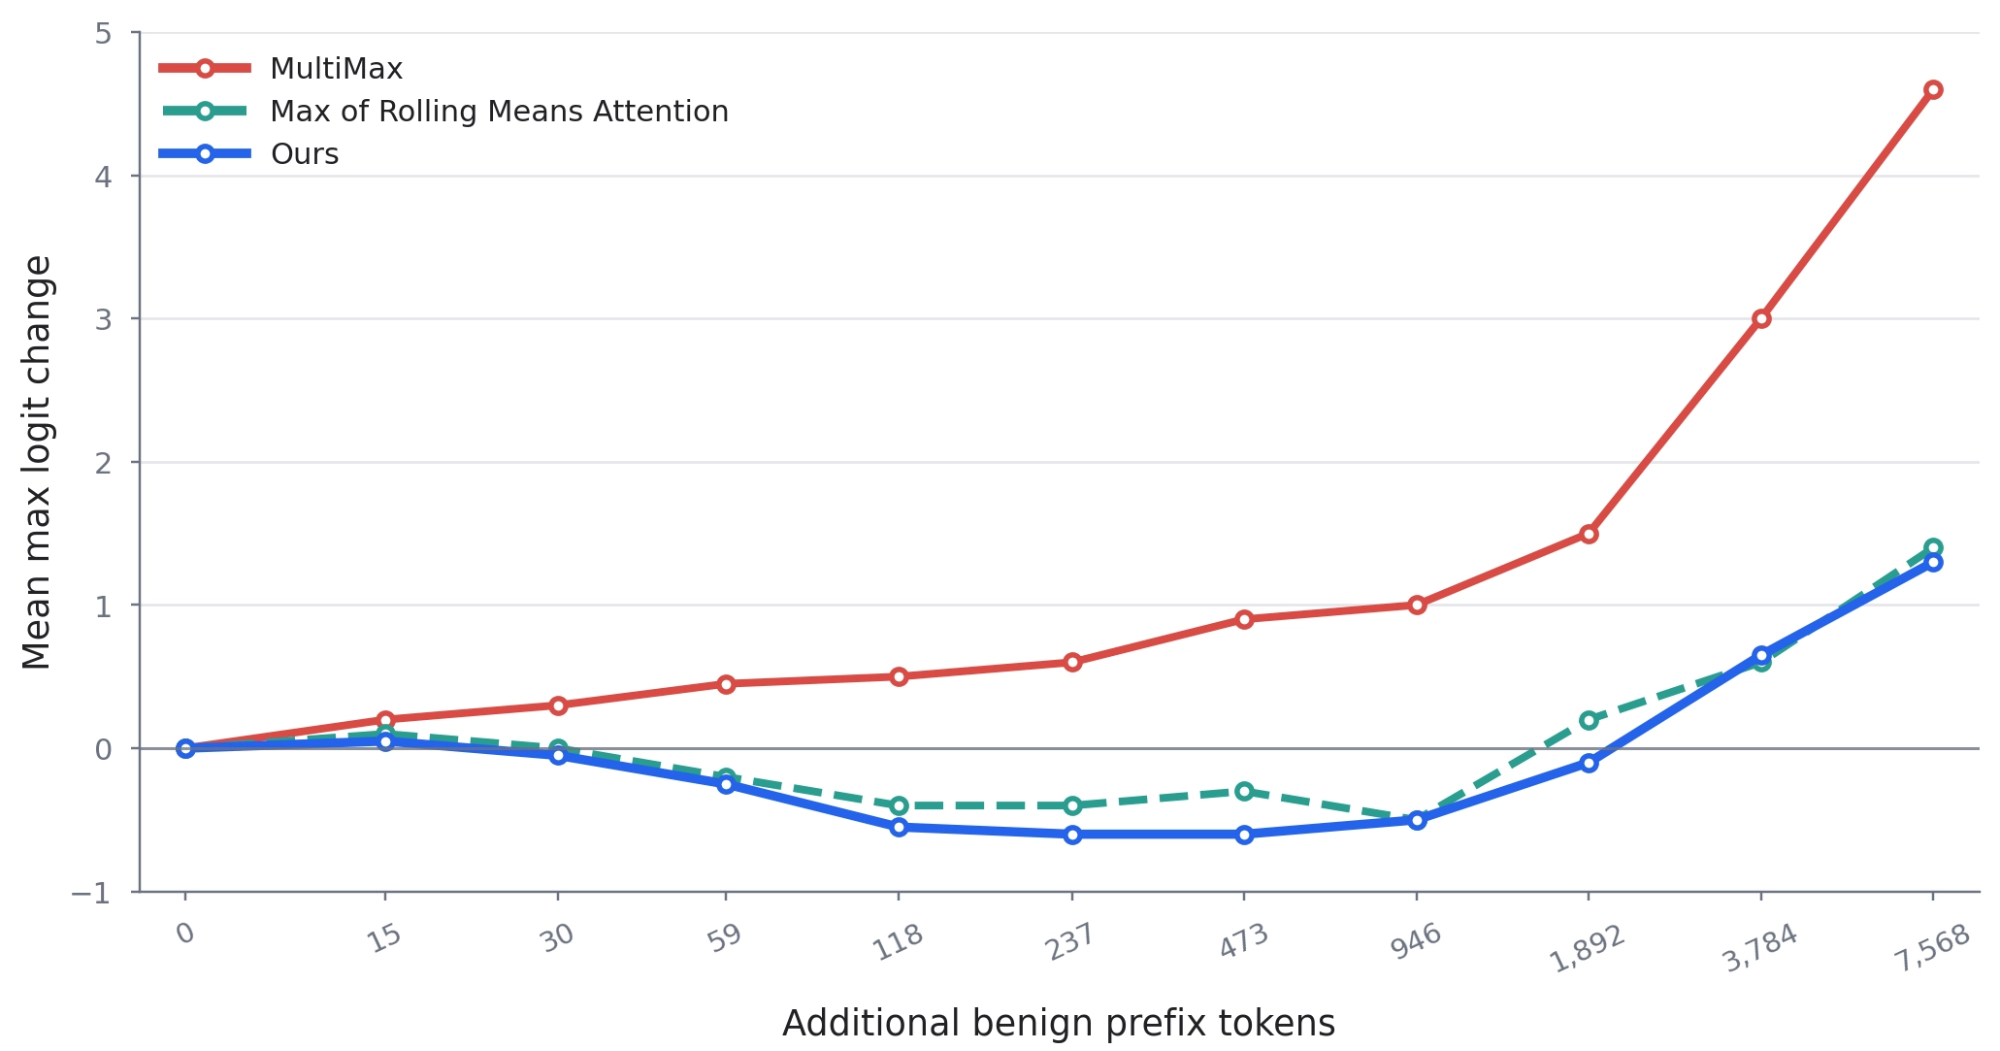
在选择架构的过程中,我们做了鲁棒性实验,检验探针预测对助手消息中违规后缀之前所放置的良性 token 序列是否保持不变。我们观察到,MultiMax 探针架构 [Kramar et al., 2026] 受良性前缀的影响明显大于 Max of Rolling Means Attention 架构 [Kramar et al., 2026],而后者与我们的指数衰减注意力架构非常相似(图 1)。
滚动 softmax 目标
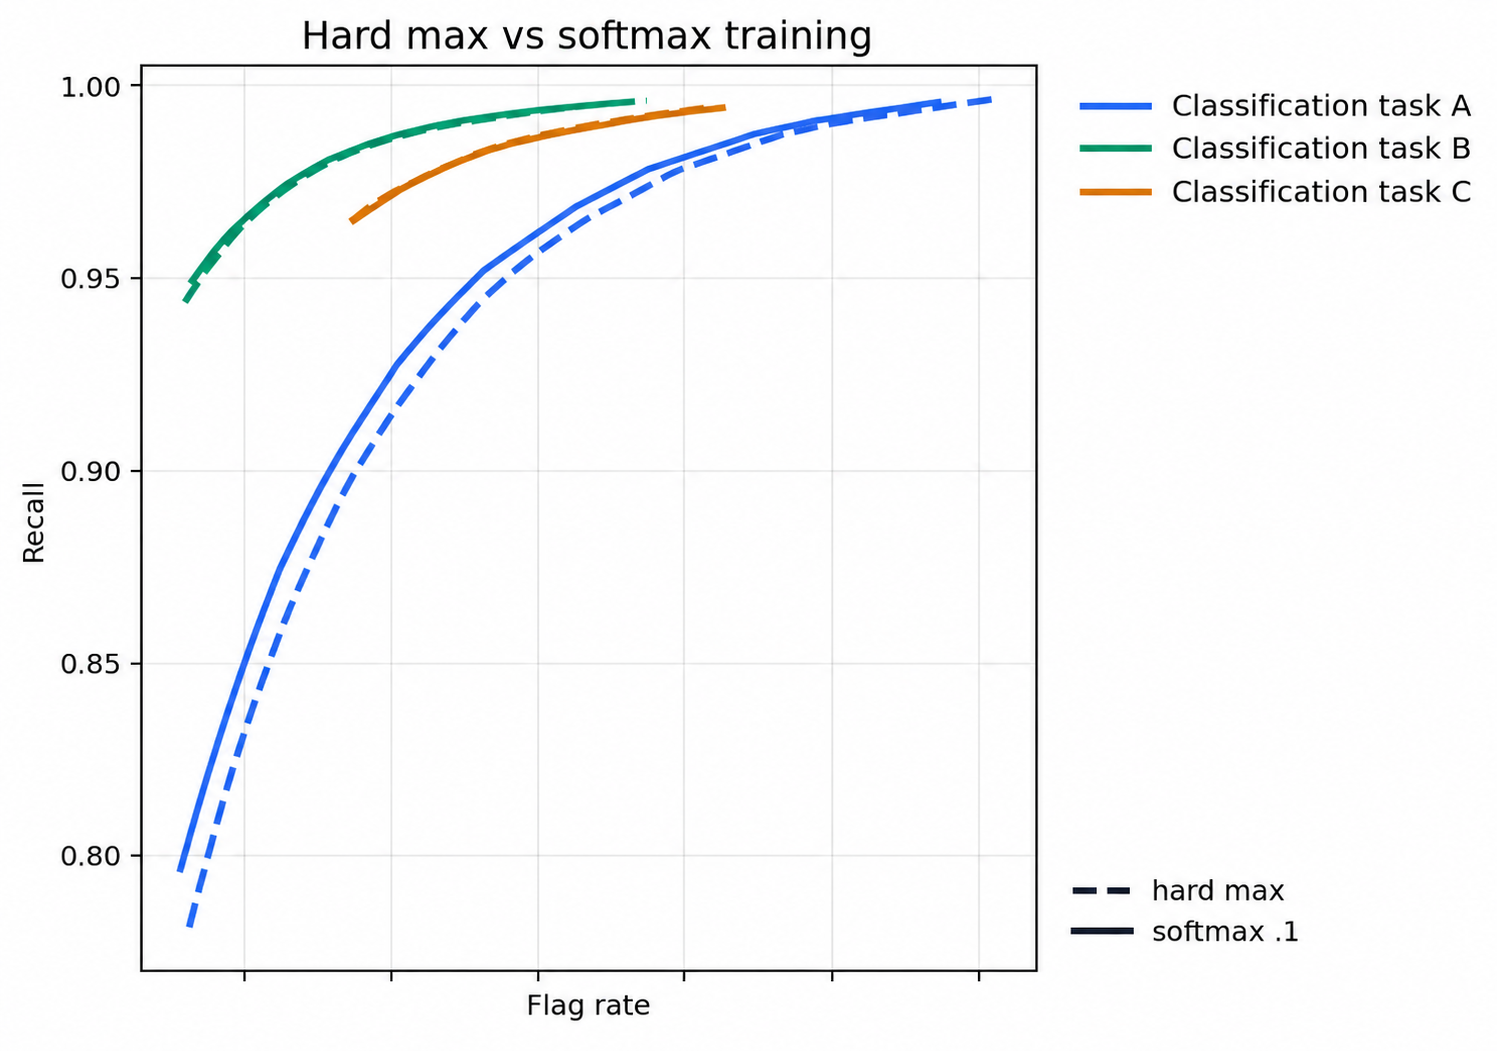
与 [Kramar et al., 2026] 和 [Cunningham et al., 2026] 类似,我们训练探针时每条消息只用一个标签。因此,架构和训练目标必须把学习集中在相关的 token 位置上。推理时,随着助手回复被逐 token 采样,探针对每个消息前缀计算一个分数,一旦该分数越过阈值,我们就将该消息标记出来。训练时,我们用 softmax 运算聚合这些分数,得到单个消息级分数并对其施加监督。这与 Kramar et al. (2026) 的聚合方法不同,后者对各前缀分数取硬最大值。我们推测,softmax 聚合能更好地把监督分配到各个前缀上。实验表明,softmax 聚合能小幅改善召回率/标记率的帕累托前沿(图 2)。
训练、模型选择与评估
我们采用与 [Anderson et al., 2026] 类似的缩放方法来收集激活值,然后在同一批收集到的激活值上训练大量探针。通常我们最多使用 100 万条训练消息,并且在这一规模及以下都能看到分类效果的提升。数据来自合成对话与去标识化对话的混合。训练标签由我们能力最强的推理模型作为 LLM 评判员给出。
正如 [Kramar et al., 2026] 中所观察到的,探针权重的随机初始化对探针预测性能有很大且可泛化的影响。因此,对每组超参数配置,我们通常至少训练 32 个随机初始化。我们一般会扫描若干组配置,在验证集上选出表现最好的随机种子,再在留出的评估集上检查最终性能。我们发现,需要扫描的关键超参数是学习率、激活来源层和架构容量。
训练探针时,我们使用 AdamW 优化器,训练几个(<5)epoch。由于探针权重相比其需要处理的训练激活值很小,训练主要受带宽限制。因此,我们在训练时对探针权重做向量化并融合,从而在同一加速器上联合训练数十个探针,耗时几乎与训练单个探针相当。这让我们可以轻松扩展每组配置的随机种子数量。2
评估方面,我们在一个精心标注的小数据集上测量召回率,并另在一个能代表探针预期部署场景的大数据集上评估升级率(即触发探针的相关消息占比)。在不同探针阈值下,由此得到一条召回率-升级率曲线,它是我们决定探针部署与配置的主要依据。为评估探针对越狱的鲁棒性,我们还结合使用自动化与人工红队测试。
部署
探针以流式方式直接运行在推理引擎上(仅为 token 池化保留最小缓冲区),每采样一个 token 返回一个 logit。因此,探针的系统可靠性与模型本身几乎相同;特别是与外部文本分类器相比,探针更容易做到失效即关闭(fail-closed)。
系统会将分类器 logit 与每个采样 token 一起记录。只要某个 logit 超过阈值,我们就停止向用户流式输出补全内容,并将该消息升级交给推理模型做最终判断。工具调用也会被阻止,直到该调用被标记为安全。
探针的一些经验性质
模型检查点之间的迁移
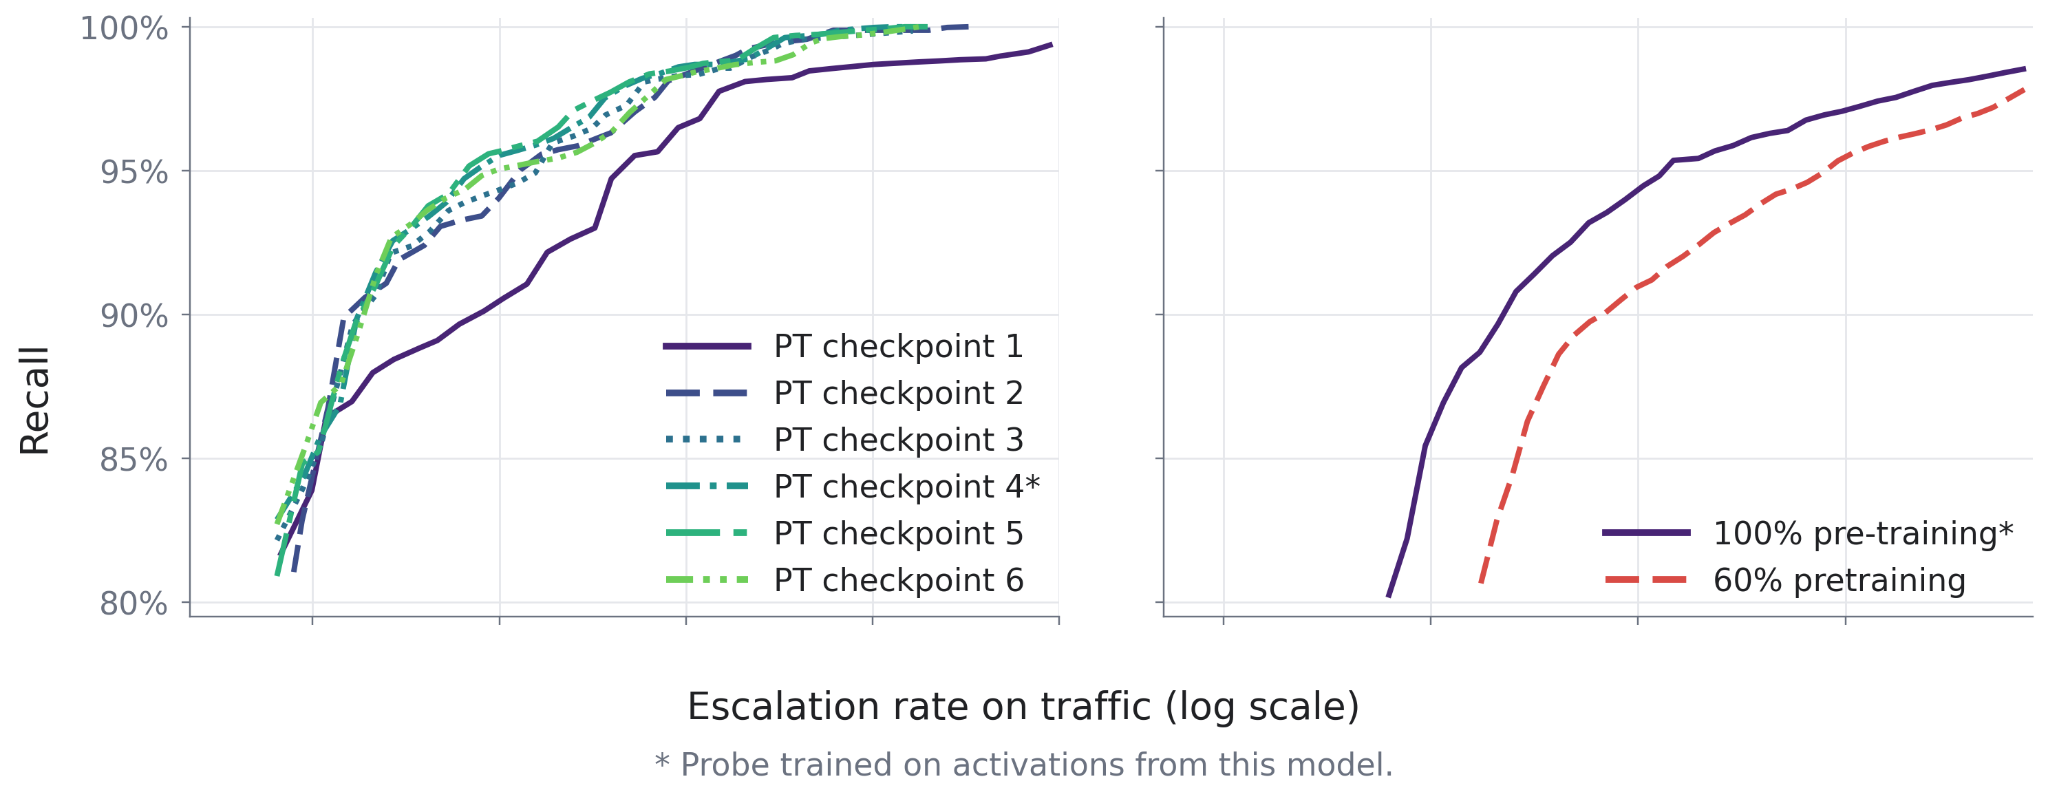
在一个模型的激活值上训练的探针,应用到另一个模型的激活值上时,行为通常会有所不同。不过,对于足够相似的模型,我们预计分类器质量下降很小。为了量化可接受的相似程度,我们评估了探针在训练后不同阶段之间,以及不同预训练量之间的迁移情况(图 3)。我们观察到,在许多训练后阶段之间迁移效果很好,而在预训练检查点之间迁移则较为有限。
对越狱的鲁棒性
已有研究表明,基于激活的监控器对某些越狱攻击具有鲁棒性,并且能与基于文本的分类器互补 [Patel and Wang, 2024],[Cunningham et al., 2026]。探针还可能检测出通过编码表达的内容——被监控的模型能理解这些编码,而外部分类器却难以解读 [Sel et al., 2026]。因此,这很可能使探针对某些类别的越狱具备鲁棒性。
对于并非直接针对探针优化的越狱,鲁棒性尤其高。不过,现实世界中的攻击可以针对我们安全栈发出的信号进行调整。因此,我们对自身的安全防护措施进行了大量红队测试 [OpenAI, 2026a]。在这些测试中,我们发现探针总体上比基于内容的分类器对越狱更鲁棒。
性能随模型能力扩展
对于固定的分类任务,文本分类器始终看到相同的输入,因此表现也相同。但探针的输入是被监控模型在固定任务实例上的激活,而这些激活在不同模型之间并不相同。包括 [Nordby et al., 2026] 在内的已有研究表明,探针准确率可以随模型能力提升而提高。我们也观察到了这一趋势,并且在我们前沿模型上,探针性能持续提升。
结论
探针已成为 OpenAI 安全与对齐策略中不可或缺的一部分。它们是我们更广泛的检测和调查前沿模型失配工作中的一个组成部分。我们正在积极训练和部署更好的探针,并扩大其覆盖的策略范围。我们计划继续发展白盒分类器的科学,着眼于提升其泛化能力和鲁棒性。
致谢
本报告主要关注与探针架构和训练相关的技术细节。在前沿模型上部署探针需要许多团队的广泛协作。我们感谢 OpenAI 安全系统团队和 Preparedness 团队中为这项工作提供帮助的许多人。我们还要感谢 Isak Czeresnia Etinger、Paul Rosu、Ian Kivlichan、Bowen Baker、Jakub Pachocki、Kai Chen 和 Gaby Raila 对本文提出的深思熟虑的意见。
脚注
- 我们还试验了线性探针(包括对来自多层的激活进行拼接)[Cunningham et al., 2026]、MultiMax 探针 [Kramar et al., 2026] 和协方差探针 [Dooms et al., 2026],但都没有提升预测性能。全注意力探针性能相近,但缺少 QV 注意力探针那种低缓冲流式实现。仅使用单层激活的探针也因推理基础设施更简单而更受青睐。↩
- 请注意,以这种方式耦合探针意味着它们以相同顺序看到数据,这可能会减少对可能探针空间的有益探索。不过,一项受控实验表明,探针性能的离散程度绝大多数源于初始化随机性(约 85% 的方差份额)。↩
来源:OpenAI:Alignment 研究博客 · alignment.openai.com